خزش صفحات وب فقط به این معنا نیست که Googlebot آدرس یک صفحه را پیدا کند و محتوای آن را دریافت کند. در عمل، قابلیت خزش یک سایت به عواملی مانند ساختار لینکها، پاسخ سرور، دسترسی به منابع صفحه، تنظیمات robots.txt و ظرفیت فنی سرور وابسته است. حتی در سایتی که صفحات زیادی دارد، ممکن است برخی URL ها بهدرستی در دسترس خزنده قرار نگیرند یا درخواستهای مکرر به صفحات کمارزش، منابع سرور را مصرف کنند.
برای بررسی این مسائل باید از توضیحات عمومی درباره نحوه کار موتور جستجو فراتر برویم و رفتار واقعی خزنده را در سطح URL، درخواست HTTP و پاسخ سرور تحلیل کنیم. این راهنما به همین موضوع میپردازد و روشهای عملی بررسی خزش را با استفاده از Google Search Console و ابزار Screaming Frog توضیح میدهد.
Googlebot و نحوه ارسال درخواست به صفحات سایت
Googlebot خزندهای خودکار است که برای دریافت صفحات وب از درخواستهای HTTP استفاده میکند. هنگامی که خزنده یک URL را بررسی میکند، سرور سایت باید به درخواست آن پاسخ دهد. نوع پاسخ، زمان دریافت اطلاعات و امکان دسترسی به منابع صفحه میتوانند بر موفقیت خزش تأثیر بگذارند.
برای مثال، اگر سرور محتوای صفحه را با کد وضعیت 200 OK برگرداند، درخواست از نظر HTTP موفق بوده است. اما این پاسخ به تنهایی تضمین نمیکند که تمام منابع صفحه در دسترس باشند یا صفحه از نظر فنی بدون مشکل پردازش شود. در مقابل، پاسخهایی مانند 404 Not Found و 503 Service Unavailable نشان میدهند که وضعیت درخواست با یک پاسخ موفق معمولی متفاوت است.
بنابراین، بررسی خزش نباید فقط به مشاهده یک URL در مرورگر محدود شود. لازم است وضعیت پاسخ سرور، زنجیره ریدایرکتها، دسترسی به منابع و رفتار سایت در برابر درخواستهای مختلف بررسی شود.
انواع خزندههای Googlebot هنگام ورود به سایت
گوگل از خزندههای مختلفی برای اهداف متفاوت استفاده میکند. Googlebot Smartphone یکی از خزندههای مرتبط با جستجوی وب است و گوگل در فرایندهای خود از خزندههای مخصوص موبایل نیز استفاده میکند. در نتیجه، طراحی و پیادهسازی سایت باید بهگونهای باشد که محتوای اصلی و اطلاعات مهم آن در نسخه موبایل نیز قابلدسترسی باشند.
اگر نسخه موبایل سایت نسبت به نسخه دسکتاپ محتوای متفاوتی ارائه کند، لینکهای مهمی را حذف کرده باشد یا دسترسی به منابع ضروری در آن محدود شده باشد، بررسی فنی سایت باید این تفاوتها را در نظر بگیرد.
تشخیص درخواستهای واقعی Googlebot
مشاهده عبارت Googlebot در هدر User-Agent بهتنهایی اثبات نمیکند که درخواست واقعاً از طرف گوگل ارسال شده است؛ زیرا این مقدار میتواند جعل شود.
برای تأیید هویت خزنده، گوگل روشهایی مانند بررسی Reverse DNS و سپس بررسی Forward DNS را معرفی کرده است. همچنین میتوان از محدودههای IP رسمی منتشرشده برای خزندههای گوگل استفاده کرد. این موضوع بهویژه هنگام تحلیل لاگ سرور، تنظیم فایروال یا بررسی درخواستهای غیرعادی اهمیت دارد.
لینکهای قابل خزش برای Googlebot
وجود لینک در صفحه لزوماً به این معنا نیست که خزنده میتواند آن را به شکل قابلاعتماد دنبال کند. ساختار HTML لینک و نحوه پیادهسازی تعاملات سایت در این موضوع اهمیت دارند.
گوگل معمولاً لینکهایی را که با عنصر استاندارد <a> و ویژگی href ساخته شدهاند، بهتر تشخیص میدهد. برای نمونه:
<a href="/technical-seo/">آموزش سئو تکنیکال</a>در این ساختار، مقصد لینک بهصورت مشخص در کد HTML وجود دارد. در مقابل، اگر انتقال کاربر به صفحه دیگر فقط با اجرای یک رویداد JavaScript روی یک عنصر غیرلینکی انجام شود، ممکن است کشف مقصد برای خزنده به سادگی لینک استاندارد نباشد.
برای نمونه، ساختاری مانند زیر بهتنهایی یک لینک استاندارد HTML محسوب نمیشود:
<div onclick="openPage()">مشاهده صفحه</div>در چنین شرایطی، بهتر است مسیرهای اصلی دسترسی به صفحات مهم سایت با لینکهای HTML استاندارد پیادهسازی شوند. استفاده از JavaScript برای تعاملات رابط کاربری مانعی ذاتی برای سئو نیست؛ مسئله این است که دسترسی به URLهای مهم فقط به رویدادهای تعاملی وابسته نباشد.
بررسی خزش لینکهای داخلی
در سایتهای بزرگ، بررسی دستی لینکها روش مناسبی نیست. Screaming Frog SEO Spider میتواند سایت را بخزد و اطلاعاتی درباره URLها، لینکهای داخلی، کدهای وضعیت و مسیرهای دسترسی ارائه دهد.
برای بررسی اولیه:
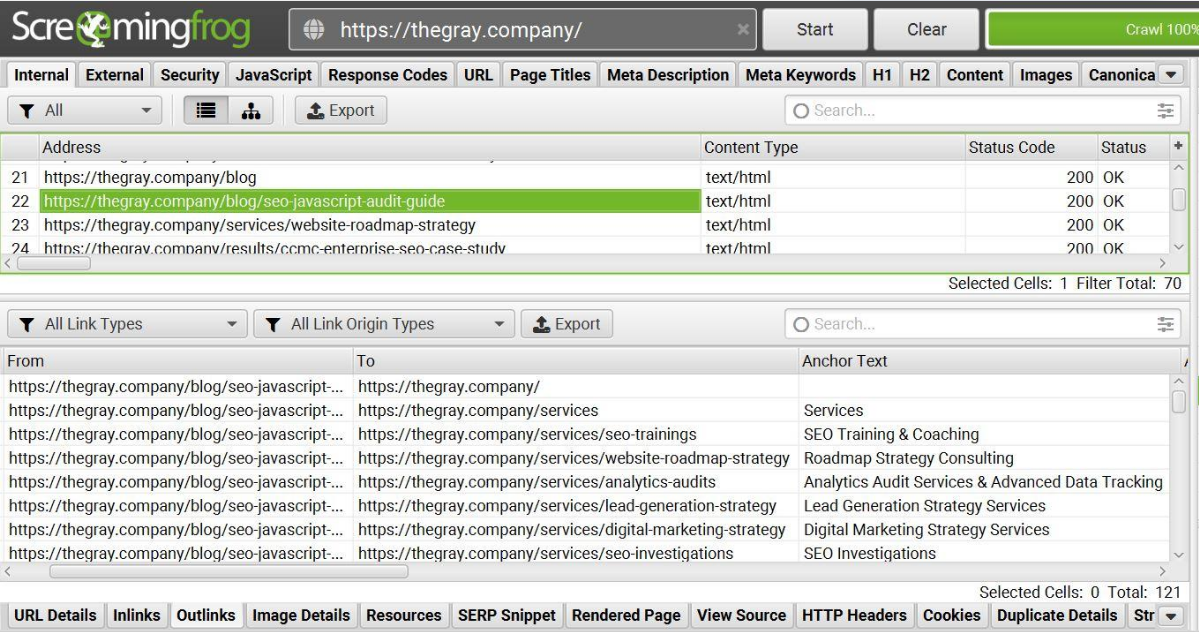
در تحلیل نتایج باید توجه داشت که Screaming Frog سایت را از دید خزنده خودش بررسی میکند، نه از دید کامل Googlebot. تنظیمات خزیدن، محدودیتهای دسترسی و تفاوت رفتار خزندهها ممکن است باعث شوند نتایج دو ابزار دقیقاً یکسان نباشند.
Googlebot چگونه تصمیم میگیرد چه زمانی یک URL را دوباره خزش کند؟
گوگل برای بررسی تمام URLهای وب، برنامه زمانی ثابت و یکسانی ندارد. فاصله میان دو خزش یک صفحه ممکن است با صفحه دیگر متفاوت باشد و حتی یک URL مشخص نیز در طول زمان با فاصلههای متفاوتی دوباره بررسی شود.
در برنامهریزی خزش، دو مفهوم مهم مطرحاند: تقاضای خزش (Crawl Demand) و ظرفیت خزش (Crawl Capacity).
تقاضای خزش به میزان تمایل سیستم گوگل برای بررسی مجدد URLها مربوط است. اهمیت URL برای وب، میزان بهروزرسانی محتوا و شناخت گوگل از صفحات میتوانند در این زمینه نقش داشته باشند. ظرفیت خزش نیز به توانایی خزنده برای ارسال درخواستها بدون ایجاد فشار نامناسب بر سرور وابسته است.
به همین دلیل، صرفاً افزایش تعداد صفحات سایت یا انتشار محتوای بیشتر به معنای افزایش متناسب تعداد درخواستهای Googlebot نیست.
تأثیر بهروزرسانی صفحه بر خزش فوری آن
خیر. بهروزرسانی یک صفحه ممکن است در تصمیم گوگل برای بررسی مجدد آن مؤثر باشد، اما زمان خزش را تضمین نمیکند. همچنین ثبت تاریخ تغییر در Sitemap نباید برای اعلام تغییراتی استفاده شود که واقعاً در محتوای صفحه رخ ندادهاند.
ویژگی lastmod در Sitemap زمانی مفید است که تاریخ تغییر واقعی و معنادار صفحه را منعکس کند. تغییر مصنوعی این تاریخ برای تمام URLها، راهکار قابلاتکایی برای وادار کردن گوگل به خزش بیشتر نیست.
برای URLهای مهم میتوان از ابزار URL Inspection در سرچ کنسول استفاده کرد و در شرایط مناسب درخواست بررسی مجدد داد؛ بااینحال، درخواست دستی جایگزین مدیریت صحیح لینکها، دسترسی خزنده و سلامت فنی سایت نمیشود.
تأثیر robots.txt بر خزش سایت
فایل robots.txt به خزندههای سازگار اعلام میکند که دسترسی به کدام مسیرها مجاز یا محدود است. این فایل معمولاً در ریشه دامنه قرار میگیرد؛ برای مثال:
https://example.com/robots.txtیک نمونه ساده از قوانین این فایل:
User-agent: *Disallow: /private/Allow: /private/public-info/در این مثال، دسترسی خزندههای مشمول قانون به مسیر /private/ محدود شده است، اما مسیر مشخصشده با Allow استثنا محسوب میشود. تفسیر دقیق قوانین به مسیر URL و قواعد تطبیق مربوط است؛ بنابراین بهتر است تغییرات robots.txt قبل از انتشار، بهویژه در سایتهای بزرگ، بهدقت بررسی شوند.
اشتباهات رایج در تنظیم robots.txt
یکی از خطاهای پرریسک، مسدود کردن مسیرهایی است که صفحات مهم یا منابع ضروری سایت در آنها قرار دارند. برای مثال، اگر قانون Disallow بهصورت گسترده تنظیم شود، ممکن است دسترسی خزنده به تعداد زیادی از URLهای مهم محدود شود.
اشتباه دیگر، استفاده از robots.txt بهعنوان ابزار قطعی حذف صفحات از نتایج جستجو است. این فایل برای کنترل دسترسی خزنده به مسیرها طراحی شده است و بهتنهایی تضمین نمیکند که URL از نتایج جستجو حذف شود. در بعضی شرایط، ممکن است آدرس یک صفحه حتی بدون دسترسی خزنده به محتوای آن شناخته یا نمایش داده شود.
پیش از اعمال تغییر در robots.txt، باید مشخص شود هدف دقیق چیست: محدود کردن خزش یک مسیر، کنترل منابع مصرفی، یا جلوگیری از حضور یک صفحه در نتایج جستجو. این اهداف الزاماً با یک دستور واحد محقق نمیشوند.
تأثیر کدهای HTTP بر خزش Googlebot
کد وضعیت HTTP یکی از مهمترین دادهها برای تحلیل رفتار خزنده است. این کد نشان میدهد سرور در پاسخ به درخواست چه وضعیتی را گزارش کرده است. بررسی آن در کنار URL و الگوی وقوع خطا، به تشخیص مشکلات خزش کمک میکند.
| کد وضعیت | مفهوم کلی | اقدام پیشنهادی در بررسی سئو |
|---|---|---|
| 200 | درخواست موفق | بررسی کنید محتوای مورد انتظار واقعاً ارائه میشود. |
| 301 | ریدایرکت دائمی | مقصد نهایی، زنجیره ریدایرکت و لینکهای ورودی را بررسی کنید. |
| 302 | ریدایرکت موقت | مطمئن شوید نوع ریدایرکت با هدف انتقال سازگار است. |
| 404 | صفحه پیدا نشد | مشخص کنید URL عمداً حذف شده یا لینک اشتباه است. |
| 429 | درخواستهای بیش از حد مجاز | محدودیت نرخ درخواست و پاسخ سرور را بررسی کنید. |
| 500 | خطای داخلی سرور | خطاهای برنامه، لاگها و منابع سرور را بررسی کنید. |
| 503 | سرویس موقتاً در دسترس نیست | وضعیت قطعی، نگهداری سرور یا محدودیت منابع را بررسی کنید. |
این جدول یک راهنمای اولیه است؛ هیچ کد وضعیتی نباید بدون توجه به زمینه آن تفسیر شود. برای مثال، پاسخ 404 برای URLی که عمداً حذف شده ممکن است درست باشد، اما همین پاسخ برای صفحه محصول فعال میتواند نشاندهنده یک مشکل جدی باشد.
تأثیر خطاهای سرور بر کاهش نرخ خزش
بله. اگر گوگل با خطاهای مکرر سرور یا محدودیت درخواست مواجه شود، ممکن است برای جلوگیری از فشار بیشتر، نرخ خزش را کاهش دهد. این مسئله در سایتهایی که پاسخدهی کند یا ناپایدار دارند اهمیت ویژهای پیدا میکند.
برای عیبیابی، بهتر است زمان وقوع خطاها با لاگ سرور و تغییرات زیرساختی تطبیق داده شود. اگر خطاها در زمان انتشار نسخه جدید، اجرای کمپین یا افزایش ترافیک رخ میدهند، بررسی منابع سرور، تنظیمات WAF، فایروال و محدودیتهای نرخ درخواست میتواند به یافتن علت کمک کند.
تفاوت robots.txt و noindex در مدیریت صفحات
این دو سازوکار اهداف متفاوتی دارند و نباید جایگزین یکدیگر در نظر گرفته شوند.
robots.txt دسترسی خزنده به مسیرهای مشخص را محدود میکند. در مقابل، دستور noindex به خزندهای که به صفحه دسترسی دارد اعلام میکند آن صفحه نباید در ایندکس قرار بگیرد.
برای نمونه، دستور زیر میتواند در متای صفحه قرار بگیرد:
<meta name="robots" content="noindex">اگر صفحهای را در robots.txt مسدود کرده باشید، ممکن است خزنده نتواند محتوای آن را دریافت کند و در نتیجه دستور noindex داخل همان صفحه را نبیند. به همین دلیل، اگر هدف جلوگیری از حضور صفحه در نتایج جستجو است، باید مطمئن شوید گوگل امکان دسترسی به صفحه و مشاهده دستور مربوط را دارد.
این موضوع در صفحات فیلترشده، URLهای پارامتردار، صفحات آزمایشی و بخشهایی از سایت که محتوای تکراری ایجاد میکنند، اهمیت دارد. پیش از انتخاب راهکار، باید مشخص شود آیا هدف کاهش درخواستهای خزنده است یا کنترل حضور URL در نتایج جستجو.
Crawl Budget و زمان مدیریت آن
بودجه خزش یا Crawl Budget به چارچوبی برای درک میزان خزش قابلانجام و تقاضای خزش URLها اشاره دارد. نباید آن را یک سهمیه ثابت و یکسان برای تمام سایتها در نظر گرفت؛ همچنین هر سایتی برای بهبود سئو به مدیریت پیچیده بودجه خزش نیاز ندارد.
مدیریت این موضوع معمولاً برای سایتهای بزرگ، سایتهایی با تغییرات مکرر یا وبسایتهایی که تعداد زیادی URL کمارزش و تکراری تولید میکنند اهمیت بیشتری پیدا میکند.
فرض کنید یک فروشگاه اینترنتی با فیلترهای قیمت، رنگ، برند و موجودی، ترکیبهای متعددی از URL ایجاد میکند. اگر تعداد زیادی از این آدرسها محتوای مشابهی داشته باشند، بررسی وضعیت آنها میتواند بخشی از منابع خزش را به URLهایی اختصاص دهد که ارزش مستقل چندانی ندارند. این مسئله در سئو سایت فروشگاهی اهمیت ویژهای دارد؛ زیرا مدیریت فیلترها، صفحات دستهبندی و مسیرهای دسترسی به محصولات بر ساختار فنی سایت اثر میگذارد.
شناسایی URL های کمارزش
برای شروع، URLهای سایت را بر اساس الگوی ساختاری بررسی کنید. پارامترهای فیلتر، مرتبسازی، شناسههای رهگیری و ترکیبهای مختلف مسیر ممکن است URLهای زیادی ایجاد کنند. سپس مشخص کنید کدامیک از این آدرسها واقعاً برای کاربران ارزش مستقل دارند و کدامیک نسخههای تکراری یا کماهمیت محسوب میشوند.
اقدامات زیر میتوانند به مدیریت بهتر خزش کمک کنند:
مسدود کردن تعداد زیادی از URLها در robots.txt بدون بررسی رفتار سایت، لزوماً بهترین راهکار نیست. باید مشخص شود محدودیت خزش چه اثری بر دسترسی گوگل به صفحات مهم و منابع موردنیاز آنها خواهد داشت.
تحلیل گزارش Crawl Stats در سرچ کنسول
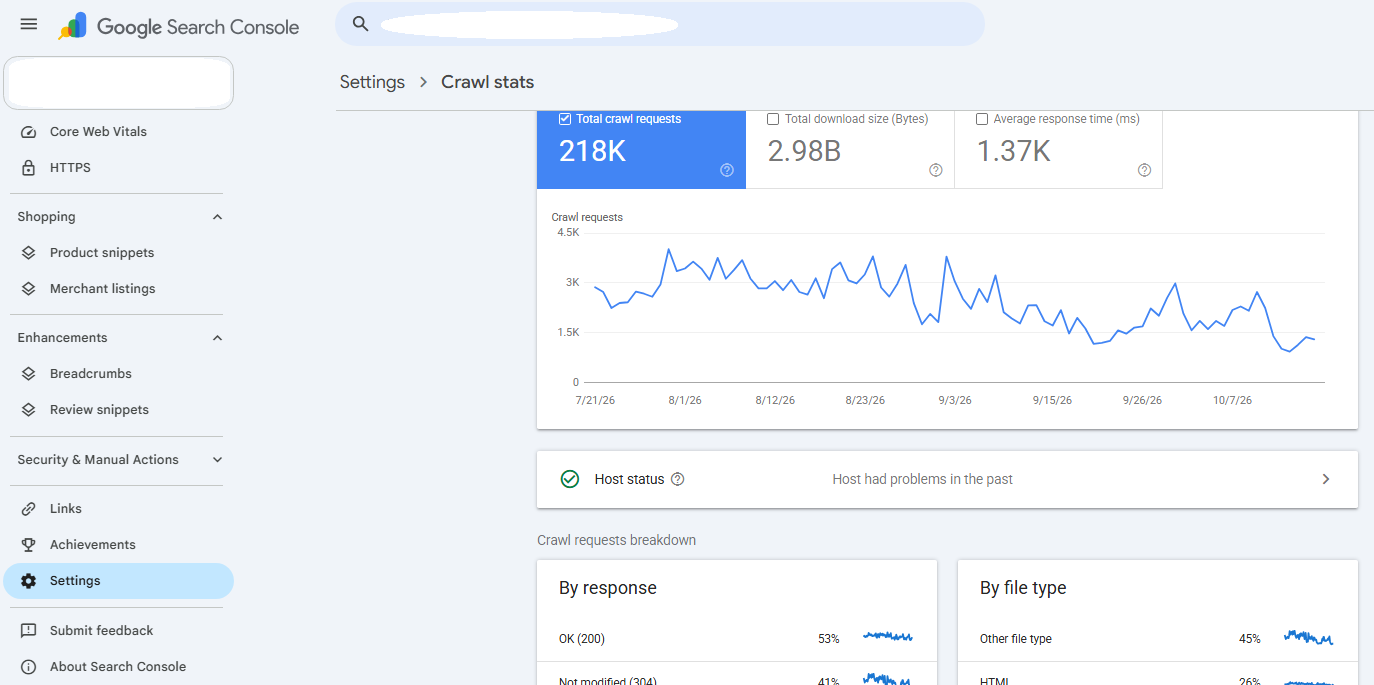
گزارش Crawl Stats در Google Search Console اطلاعاتی درباره درخواستهای خزش گوگل به سایت ارائه میدهد. این گزارش بهویژه برای بررسی روند خزش، وضعیت پاسخ سرور و تشخیص تغییرات غیرعادی مفید است.
در تحلیل این گزارش، فقط به تعداد درخواستها توجه نکنید. تعداد زیاد درخواستها بهتنهایی نشانه عملکرد بهتر نیست و کاهش تعداد آنها نیز همیشه به معنای وجود مشکل نیست. باید دادهها را در کنار وضعیت سایت، تغییرات اخیر و نوع پاسخ سرور تفسیر کرد.
شاخصهای مهمتر در تحلیل خزش
تعداد درخواستهای خزش: روند درخواستها را در بازه زمانی بررسی کنید. اگر تغییر شدیدی رخ داده است، آن را با انتشار نسخه جدید، تغییرات URL یا مشکلات زیرساختی مقایسه کنید.
میانگین زمان پاسخ سرور: افزایش زمان پاسخ میتواند نشانه فشار منابع یا کندی زیرساخت باشد. این شاخص را در کنار لاگ سرور و وضعیت عملکرد سایت بررسی کنید.
حجم دانلودشده: تغییر محسوس در حجم دادههای دریافتشده میتواند ناشی از تغییر نوع صفحات، حجم منابع یا نحوه پاسخدهی سایت باشد.
کدهای پاسخ HTTP: سهم پاسخهای موفق، ریدایرکتها و خطاها را بررسی کنید. افزایش خطاهای 5xx یا 429نیازمند بررسی دقیقتر است.
نوع فایل و هدف خزش: این دادهها کمک میکنند مشخص شود چه نوع منابعی درخواست شدهاند و الگوی خزش با ساختار سایت همخوانی دارد یا خیر.
تفاوت Crawl Stats با URL Inspection
Crawl Stats برای بررسی الگوی کلی درخواستهای خزش در سطح سایت مناسب است. URL Inspection برای بررسی یک URL مشخص و مشاهده اطلاعات مربوط به وضعیت آن کاربرد دارد. این دو ابزار مکمل یکدیگرند: اولی روندها را نشان میدهد و دومی امکان بررسی جزئیتر یک صفحه را فراهم میکند.
برای مثال، اگر در Crawl Stats افزایش خطاهای سرور مشاهده شود، میتوان بازه زمانی مربوط را با لاگهای سرور تطبیق داد و سپس URLهای مهم را جداگانه بررسی کرد. اگر مشکل فقط در یک صفحه رخ داده باشد، بررسی مستقیم همان URL ممکن است مسیر عیبیابی دقیقتری فراهم کند.
عیبیابی مشکلات خزش با Screaming Frog
Screaming Frog یکی از ابزارهای کاربردی برای بررسی ساختار لینکها و وضعیت URLهای سایت است. این ابزار بهتنهایی رفتار Googlebot را بهطور کامل شبیهسازی نمیکند، اما برای شناسایی بسیاری از مشکلات فنی مرتبط با دسترسی و لینکها مفید است.
برای یک بررسی اولیه، این مراحل را دنبال کنید:
توجه داشته باشید که دیده نشدن یک URL در خزش Screaming Frog لزوماً ثابت نمیکند که گوگل نیز آن را خزش نمیکند. تنظیمات ابزار، محدودیتهای دسترسی، عمق خزش و روش کشف URLها میتوانند در نتایج اثر بگذارند. برای تحلیل دقیقتر، یافتههای ابزار را با دادههای سرچ کنسول و در صورت دسترسی با لاگ سرور تطبیق دهید.
چکلیست فنی برای بررسی مشکلات خزش
اگر گمان میکنید Googlebot در دسترسی به صفحات سایت با مشکل مواجه است، بررسی را بهترتیب زیر انجام دهید:
اگر همه موارد بالا درست به نظر میرسند اما صفحه همچنان وضعیت مورد انتظار را ندارد، نباید فوراً مشکل را به بودجه خزش نسبت داد. ابتدا باید مشخص شود مسئله واقعاً در دسترسی خزنده است یا به مرحله دیگری از پردازش صفحه مربوط میشود.
جمع بندی
تحلیل فنی خزش زمانی نتیجهبخش است که بهجای تمرکز صرف بر تعداد درخواستهای Googlebot، رفتار واقعی خزنده و پاسخ سرور بررسی شود. ساختار لینکهای قابلخزش، تنظیم درست robots.txt، مدیریت کدهای HTTP، پایداری سرور و کنترل URLهای غیرضروری از مهمترین بخشهای این بررسی هستند.
برای سایتهای بزرگ، تحلیل Crawl Stats و لاگ سرور در کنار Screaming Frog میتواند به شناسایی الگوهای غیرعادی و اولویتبندی اصلاحات کمک کند. مهمتر از همه، هر مشکل باید بر اساس شواهد بررسی شود؛ نه اینکه کاهش خزش، ایندکس نشدن یا افت عملکرد صفحه بدون تحلیل فنی به یک علت واحد نسبت داده شود.
برای آشنایی با تصویر کلیتر فرایند جستجو، میتوانید مقاله معماری موتور جستجو را مطالعه کنید و از این مقاله بهعنوان راهنمای بررسی جزئیات فنی خزش استفاده کنید.